Multi-core
VPP memproses paket di worker thread, satu per core. Makin banyak worker, makin banyak trafik yang bisa diteruskan. Asalkan koneksi-koneksinya terbagi rata ke semua worker.
Pembagian core otomatis
Secara default (auto), router menghitung sendiri pembagian CPU setiap kali boot, dari topologi CPU yang boleh dipakainya (cpuset atau affinity ikut dihormati):
| Core fisik | Thread utama VPP | Worker VPP |
|---|---|---|
| 1 | CPU 0 | tidak ada |
| 2–7 | CPU 0 (berbagi dengan Linux, FRR, SSH) | 1 per core fisik lainnya |
| 8 atau lebih | CPU 0 | Semua core fisik, kecuali core ke-2 yang disisakan untuk Linux/FRR (misalnya BGP full table) |
- Hyper-threading: worker hanya ditempatkan di satu thread per core fisik. Dua worker di satu core fisik saling berebut dan justru lebih lambat. Core fisik dikenali dari daftar sibling kernel (
core_cpus_list/thread_siblings_list), sehingga juga benar di CPU multi-die seperti AMD EPYC. - Menyesuaikan sendiri: kalau VM di-resize atau hardware diganti, pembagiannya berubah sendiri setelah reboot atau
restart dataplane. - Buffer paket juga dihitung otomatis: satu ring RX per antrean, satu ring TX per thread per port, ditambah cache tiap thread. Kalau hugepages tidak cukup, router memberi peringatan beserta jumlah hugepages yang dibutuhkan.
Hasilnya bisa dilihat di show dataplane:
admin@r2> show dataplane
Driver: dpdk
CPU:    4 CPUs (4 physical cores); VPP main thread on CPU 0, 3 workers on CPU 1-3 (auto)
Buffers: 24576 per NUMA node
Contoh dari lab: dengan konfigurasi yang sama, R1 (3 vCPU) mendapat 2 worker, sedangkan R2 (4 vCPU) mendapat 3 worker.
Membagi koneksi ke worker
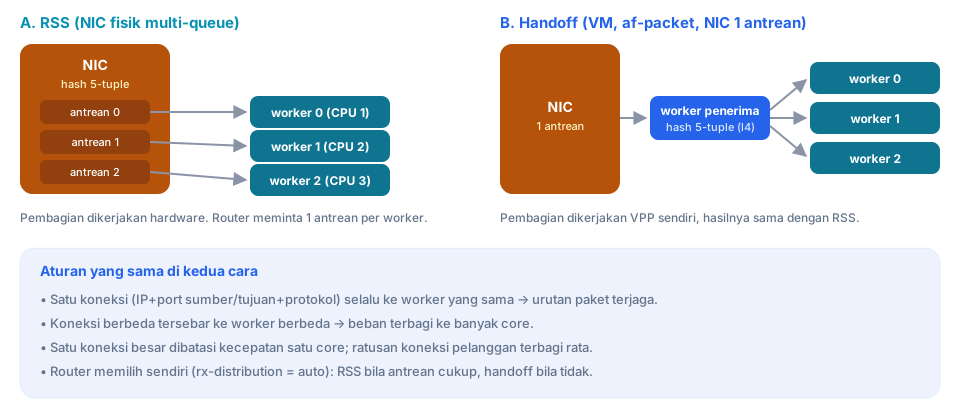
Setiap koneksi (IP + port sumber/tujuan + protokol) selalu diproses oleh worker yang sama, supaya urutan paketnya tidak teracak. Koneksi yang berbeda dibagi ke worker yang berbeda.
Router memilih caranya sendiri (rx-distribution = auto):
| Cara | Kapan | Bagaimana |
|---|---|---|
| RSS | NIC punya antrean RX ≥ jumlah worker (Intel, Mellanox) | Router meminta 1 antrean per worker; NIC membagi berdasarkan hash 5-tuple |
| Handoff | NIC dengan antrean kurang (virtio di VM, af-packet, NIC murah) | Worker penerima membagi paket ke worker lain berdasarkan hash 5-tuple (set interface handoff … l4) |
Pilihan per port tercatat di show dataplane queues:
admin@r2> show dataplane queues
workers 3
eth1: handoff l4 (1 queue)
eth2: handoff l4 (1 queue)

Thread 1 (vpp_wk_0):
 node dpdk-input:
    eth1 queue 0 (polling)
Thread 2 (vpp_wk_1):
 node dpdk-input:
    eth2 queue 0 (polling)
Memastikan pembagian berjalan
admin@r2> clear dataplane statistics
    (jalankan trafik dengan banyak koneksi MELEWATI router, misalnya iperf3 -P 32)
admin@r2> show dataplane load
Thread     Core    Forwarded  Share    Avg pps Vec/call  Bar
----------------------------------------------------------------
vpp_main      0            0   0.0%          0     0.00
vpp_wk_0      1        12198  35.5%        424    18.06  #######
vpp_wk_1      2        13570  39.5%        471     5.33  ########
vpp_wk_2      3         8624  25.1%        299    16.50  #####
| Kolom | Arti |
|---|---|
| Forwarded | Paket yang di-routing worker ini sejak clear dataplane statistics |
| Share | Porsinya dari total |
| Avg pps | Rata-rata paket per detik sejak clear |
| Vec/call | Rata-rata paket per batch. Sekitar 1 berarti ringan, 256 berarti jenuh |
Hal yang perlu diketahui
Satu koneksi = satu core
Satu koneksi besar (misalnya satu sesi download) dibatasi kecepatan satu core. Pembagian terjadi antar koneksi, dan itulah sifat trafik pelanggan yang sebenarnya.
Pembagian berbasis hash itu acak per koneksi
Dengan 8 koneksi, pembagiannya bisa timpang (misalnya 75/25). Dengan 32 koneksi atau lebih, hasilnya mendekati rata. Trafik nyata berisi ratusan hingga ribuan koneksi.
Mengatur manual
Di /etc/cidr/dataplane.conf (lalu restart dataplane):
main-core = 0
workers = 2-5          # atau: auto | none
rx-distribution = auto # auto | rss | handoff | off
buffers = auto         # atau angka
CPU yang tidak ada di mesin ini diabaikan dengan pesan, sehingga VPP tetap bisa start. Lihat dataplane.conf.